تعديل النص العربي داخل ملف PDF في المتصفح
· مدة القراءة: 9 دقائق
في محرر BlendPDF تفتح ملف PDF، وتضغط على سطر عربي، وتكتبه من جديد، ثم تحفظ. والنتيجة حروف متصلة، وسطر يبدأ من الهامش الأيمن كما كان، مكتوب بخط الملف نفسه ما دام هذا الخط يضم الحروف التي كتبتها. وبعد الحفظ يمكن البحث في السطر ونسخه. ويجري كل ذلك في المتصفح، فلا يُرفع ملفك.
أغلب المحررات على الإنترنت لا تفعل هذا بعد. فمحرر Sejda نفسه ينبّه إلى أن الكتابة من اليمين إلى اليسار غير مدعومة بالكامل، وiLovePDF يقول إن محرر المحتوى فيه لا يدعم اللغات المكتوبة من اليمين إلى اليسار. وحين جرّبنا المحررات المجانية في 12 نوفمبر 2026، حفظ PDF24 وPdfBayt السطر العربي الذي أضفناه صورةً، وحفظه PDF Candy نصًا حقيقيًا لكن بكلمات معكوسة الترتيب. الملفات كلها في صفحات المقارنة.
يشرح هذا المقال لماذا يصعب ذلك وكيف تعاملنا معه، ثم أين لا يزال المحرر يفشل. والمشروع مفتوح المصدر: الشيفرة المصدرية على GitHub برخصة AGPL-3.0.
ملف PDF لا يعرف الحروف
ما يحفظه ملف PDF من النص هو قائمة أرقام glyphs في خط ما، يُرسم كل منها في موضع محدد من الصفحة. والـglyph هو رسم الحرف داخل الخط، وليس في الصفحة ما يدلّ على الحرف الذي يمثّله كل رسم. لذلك حين تبحث في الملف أو تنسخ منه، يرجع قارئ PDF إلى جدول ToUnicode ليعرف حرف كل رقم، وهو جدول صغير يكتبه مع الخط البرنامجُ الذي أنشأ الملف.
في النص اللاتيني يقابل كل glyph حرفًا واحدًا في الغالب، أما في العربية فلا. قد يكون للحرف الواحد أربعة أشكال، بحسب اتصاله بما قبله أو بما بعده، أو بهما معًا، أو انفصاله عنهما. واللام إذا تلتها ألف رُسمتا معًا في glyph واحد. وقد تكون للنقاط والحركات glyphs مستقلة. وعلى جدول ToUnicode أن يردّ هذا كله إلى الحروف، بمدخل واحد لكل glyph.
ففي تعديل العربية داخل ملف PDF مشكلتان في آن واحد: أن ترسم الـglyphs الصحيحة في مواضعها الصحيحة، وأن تكتب معها جدولًا يردّها إلى حروفها. وقد تبدو الصفحة سليمة تمامًا، ثم لا يجد البحث فيها شيئًا.
كتابة نص عربي جديد
تكتب أداة نص الأسطر الجديدة بثلاث مكتبات. الأولى bidi-js، وتطبّق على كل فقرة خوارزمية Unicode للنص ثنائي الاتجاه (bidi)، وهي التي ترتّب النص حين يجتمع فيه الاتجاهان. نقسم النص إلى أسطر وهو بترتيبه المنطقي، أي بالترتيب الذي كُتب به، ثم نعيد ترتيب كل سطر للعرض، فيبقى التاريخ داخل الجملة العربية مقروءًا من اليسار إلى اليمين. والثانية fontkit، وتختار أشكال الحروف (shaping) في كل مقطع من جدولي GSUB وGPOS في الخط نفسه: الأول يقرر أيّ glyph يُرسم، فيختار صيغ الوصل ولام ألف، والثاني يقرر أين يُرسم، فيضع الحركات في أماكنها. والثالثة pdf-lib، مكتبة JavaScript لإنشاء ملفات PDF وتعديلها، وبها نضع الـglyphs في الصفحة واحدًا واحدًا، ولكل منها مصفوفة نص (text matrix) مستقلة.
ولا تصلح دالة drawText في pdf-lib للعربية، لأنها لا تطبّق bidi وتُسقط كل إزاحات GPOS. ووضع الـglyphs واحدًا واحدًا يحتاج إلى أربعة من مكوّنات pdf-lib الداخلية (internals)، لذلك ثبّتنا المكتبة على الإصدار 1.17.1 بالضبط، ولدينا اختبار يفشل إن تغيّر أيٌّ منها. والخط هو Cairo، نستضيفه على نطاقنا، ولا نضمّن منه في الملف إلا الـglyphs التي يستعملها المستند (subset).
وفي هذا الجزء خطآن أخذا منا وقتًا حتى عرفنا سببهما.
«لا» التي صارت «ال». «لا» glyph واحد يمثّل حرفين. وقارئ PDF يستخرج السطر بترتيب عرضه، ثم يقلب النص المكتوب من اليمين إلى اليسار ليعيده إلى ترتيبه المنطقي، فيقلب معه أيضًا ما داخل مدخل ToUnicode المكوّن من حرفين. فإن كتبتَ المدخل «لا» وجد البحث «ال». لذلك حين يمثّل glyph واحد عدة حروف تُكتب من اليمين إلى اليسار، نخزّنها مقلوبة، فتعود صحيحة بعد القلب. أما Chrome فيخزّنها بترتيبها المنطقي، ولهذا يستخرج pdftotext كلمة «الأطلس» من صفحة الاختبار التي طبعناها من Chrome هكذا: «األطلس».
حروف اختفت من البحث بعد الحفظ الثاني. يحتفظ fontkit في ذاكرة مؤقتة (cache) بكائن واحد لكل رقم glyph، ما دام الخط محمّلًا. والـsubsetter في pdf-lib هو الجزء الذي يقتطع من الخط ما يحتاجه الملف. وحين يضمّن glyph مركّبًا، يضمّن معه الأجزاء التي يتكوّن منها، فيخزّنها fontkit دون code points، أي دون أرقام الحروف في Unicode. وفي خط Cairo حروف كثيرة هي من هذه الأجزاء: ا ح د ر س ع ه و، وأغلب الحروف اللاتينية الصغيرة، وعدد من الأرقام. كان التصدير الأول سليمًا. أما التصدير الثاني في الجلسة نفسها فأخذ هذه الحروف من الذاكرة المؤقتة دون code points، فلم يُكتب لها مدخل في ToUnicode، واختفت من نتائج البحث. وكان الحل أن نستعمل نسخة من fontkit لتخطيط النص، ونعطي الـsubsetter نسخة أخرى.
تغيير سطر موجود في الملف
إضافة النص هي النصف السهل. أما تغيير سطر موجود فيعني أن تقرأه أولًا، ثم تزيله من الصفحة دون أن تمسّ أي شيء آخر، ثم ترسم الكلمات الجديدة بحيث تنسجم مع بقية السطر.
قراءة السطر. تستخرج pdf.js (مكتبة Mozilla لعرض ملفات PDF في المتصفح) نص الصفحة بالدالة getTextContent، لكنها تقلب العناصر المكتوبة من اليمين إلى اليسار حرفًا حرفًا، فيصير glyph «لا» الذي يكتبه Chrome «ال». لذلك نملأ خانة التعديل glyph بعد glyph: نجمع الـglyphs بالترتيب الذي تُرسم به، ونقلب في المقاطع المكتوبة من اليمين إلى اليسار ترتيب الـglyphs نفسها، لا ترتيب الحروف داخلها.
إزالة السطر. نحذف السطر القديم بمكتبة PDFium، محرك PDF في Chrome، بعد ترجمتها إلى WebAssembly. ولا نحذف كل ما يقع داخل مستطيل، بل كائنات نص كاملة نختارها بخط الأساس (baseline) الذي تقع عليه. وقبل أن نعيد كتابة أي صفحة نرسمها صورةً، ثم نرسمها مرة أخرى بعد التغيير، ونقارن الصورتين في مربعات من 10 × 10 بكسل. فإن تغيّر لون أي مربع خارج الأسطر المعدّلة بأكثر من حدّ صغير، رفضنا تعديل الصفحة. وبعد الحفظ نفتح الملف من جديد، فإن بقي glyph قديم واحد على سطر استُبدل، فشل الحفظ.
رسمه من جديد بخطه الأصلي. أغلب ملفات PDF لا تضمّن من كل خط إلا الـglyphs التي استعملها المستند، فلا يمكنك أن تختار أشكال حروف النص الجديد من خط الملف مباشرة، لأن الـglyphs التي تحتاجها قد لا تكون فيه. لذلك نقرأ كل سطر يرسمه المستند بذلك الخط، ونسجّل الـglyph الذي يستعمله لكل حرف في كل شكل من أشكال وصله، ونسجّل كذلك أزواج kerning (تعديل المسافة بين حرفين بعينهما)، وموضع الحركات على كل حرف، والحروف المركّبة (ligatures). ثم نبني الكلمة المعدّلة من هذه القطع. أما الكلمات التي لم تلمسها فنعيد رسمها بالـglyphs الأصلية في مواضعها الأصلية، ولا نعيد توزيع إلا الجزء الذي تغيّر من السطر، بدءًا من حافته اليمنى في العربية.
والخطوط تجعل هذا أعقد مما يبدو. فبعضها يرسم شكلين من أشكال الحرف بـglyph واحد: الباء في خط Arial لها glyph واحد في أول الكلمة ووسطها، والحرف الذي لا يتصل إلا بما قبله، كالراء، قد يستعمل شكله المنفصل في آخر الكلمة أيضًا. وجدول cmap في الخط يربط كل حرف بالـglyph الذي يرسمه، فإذا قلبناه لنعرف حرف كل glyph، لم يذكر للـglyph المشترك إلا الشكل الأول. لذلك نقبل عند جمع الـglyphs هاتين الحالتين بعينهما، ولا نتساهل في غيرهما.
حروف فارسية في ملفات PDF العربية من Chrome
وجدنا هذه المشكلة في 12 نوفمبر 2026، ونحن نجرّب محررنا إلى جانب محرر Sejda، وأصلحناها في اليوم نفسه.
يملأ Chrome جدول ToUnicode بجدول cmap مقلوبًا، أي يكتب لكل glyph حرفًا من الحروف التي يربطها الخط به. وخط Times New Roman يرسم الهاء والهاء ذات العينين ھ (حرف فارسي وأردي) بـglyph واحد، والياء والياء الفارسية ی بـglyph واحد أيضًا، فيختار الجدول المقلوب الحرف الفارسي في الحالتين. وفي الوقت نفسه يضع Chrome كل glyph داخل وسم ActualText فيه الحرف العربي الصحيح. فيقول الـglyph الواحد شيئين مختلفين. ففي محتوى الصفحة يقع داخل وسم يقول إنه ياء عربية:
/Span <</ActualText <FEFF064A>>> BDC
<03F3> Tj
EMC
أما جدول ToUnicode في الخط فيقول إن الـglyph نفسه ياء فارسية في أول الكلمة:
<03F3> <03F4> <FBFE>| الـglyph في الصفحة | ما يقوله ToUnicode | بعد NFKC | ما تكتبه لوحة المفاتيح العربية |
|---|---|---|---|
| ياء في أول الكلمة | U+FBFE ياء فارسية في أول الكلمة | ی U+06CC | ي U+064A |
| هاء في وسط الكلمة | U+FBAD هاء ذات عينين في وسط الكلمة | ھ U+06BE | ه U+0647 |
الأدوات التي تقرأ ActualText، مثل pdftotext، تحصل على حروف عربية. أما pdf.js فتقرأ جدول ToUnicode، فإذا رُدّت أشكال العرض (presentation forms) إلى حروفها بتطبيع NFKC، تحوّلت «لديها» إلى «لدیھا». على الشاشة تبدوان كلمة واحدة، أما خانة البحث فتراهما نصّين مختلفين.
ومحررنا يقرأ النص عبر pdf.js، فكانت خانة التعديل تعرض الحروف الفارسية. وإذا حُفظ السطر بعد ذلك بخط بديل شبيه، كتبنا ما في الخانة كما هو، بحروفه الفارسية، ودون ActualText يصحّحها. فكانت كلمات السطر التي لم تلمسها تختفي من البحث بالعربية، حتى في pdftotext الذي كان يجدها في الملف الأصلي.
والإصلاح أن نقرأ هذه الحروف عربيةً حين يدلّ السطر على أنه عربي. فإذا كان في السطر حروف لا تستعملها إلا العربية (ة ك ي ى)، ولم يكن فيه شيء من الحروف التي لا تستعملها إلا الفارسية أو الأردية (پ چ ژ گ ے وأمثالها)، رددنا الحروف الشبيهة إلى أصلها شكلًا بشكل: الياء الفارسية المتصلة تصير ياءً، وغير المنقوطة في آخر الكلمة تصير ألفًا مقصورة. أما المستندات الفارسية والأردية فنتركها كما هي. وفي الأسطر التي نُبقيها بخطها الأصلي، جعلنا الهاء والهاء ذات العينين تتطابقان في كل الأشكال إلا الشكل المنفصل، فيجد السطر الـglyphs التي يحتاجها.
ويبقى جزء لم نحلّه بعد. السطر الذي نحتفظ له بخطه الأصلي يحتفظ أيضًا بجدول ToUnicode الذي في الملف، وهو ما زال يقول إن الحروف فارسية، تمامًا كالأسطر المحيطة به. وإصلاح ذلك يعني إعادة كتابة جدول الخط للصفحة كلها، ولم نفعله بعد.
حين لا يضم الخط ما كتبته
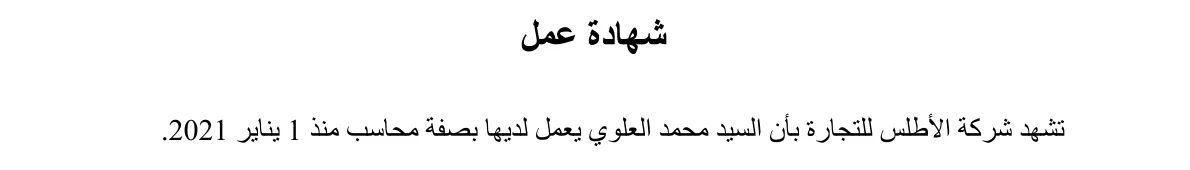
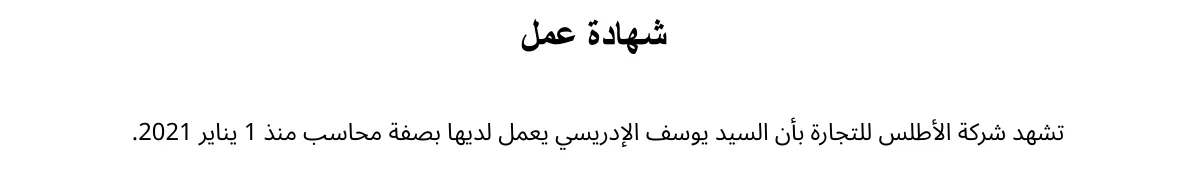
ولأن الملفات لا تضمّن إلا جزءًا من كل خط، كثيرًا ما تحتاج الكلمة المعدّلة إلى glyph ليس في الملف: اسم فيه حرف لم يستعمله المستند قط، أو رقم. عندها نعيد رسم السطر بأقرب خط من الخطوط التي نوفّرها، ونختاره بناءً على اسم الخط الأصلي وخصائصه المسجّلة في الملف (serif، ثابت العرض، عريض، مائل):
- Liberation Sans وSerif وMono بدلًا من Arial وTimes New Roman وCourier على الترتيب. لها المقاييس نفسها، فيبقى طول السطر كما هو.
- Carlito بدلًا من Calibri، وCaladea بدلًا من Cambria.
- Noto Sans Arabic للعربية، أو Cairo إن كان الملف يستعمل Cairo أصلًا.
العربية هي نقطة الضعف هنا. فالبديل الطبيعي للعربية المكتوبة بخط على طراز Times هو خط Amiri، لكن الـsubsetter في pdf-lib 1.17.1 يُفسده، فلا يظهر منه إلا glyph أو اثنان. أما Noto Naskh Arabic فيرسم نقاط أغلب الحروف glyphs منفصلة، ويستعمل glyph واحدًا بلا نقاط للحروف ب ت ث ن ي. ولأن ToUnicode لا يعطي كل glyph إلا مدخلًا واحدًا، يتعذّر ردّ سطر مكتوب بهذه الطريقة إلى نص، فلا يمكن البحث فيه. فلا يبقى للمستندات المكتوبة بخط نسخي إلا خط بسيط بلا زوائد (sans)، والفرق يظهر للعين. والمحرر ينبّهك حين يحدث ذلك.
والكلمة المعدّلة التي فيها حركات تُكتب أيضًا بالخط الشبيه، لأن ما في الملف لا يكفي لنضع الحركات في مكانها بثقة على تركيبة حروف لم ترد فيه من قبل.
ما لا يعمل بعد
- نرفض تعديل الصفحات التي فيها ظلال أو أقنعة شفافية (soft masks). السبب أن PDFium 2.15.1 يُسقط الـsoft masks حين يعيد كتابة الصفحة، فلو عدّلناها لاختفى منها ظل النص المصنوع بـCSS أو تأثير الشكل المصنوع في Word. والمقارنة بين صورتي الصفحة قبل التعديل وبعده تكشف ذلك، فلا يغيّر المحرر النص في تلك الصفحة. والحل البديل مستطيل أبيض فوق الكلمات القديمة، ثم سطر جديد بأداة نص.
- سطر واحد في كل مرة. لا تنتقل الكلمات إلى السطر التالي، لذلك تبقى إعادة كتابة فقرة كاملة عملًا لمعالج نصوص.
- قد يتغيّر الخط، كما شرحنا أعلاه، وفي العربية المكتوبة بخط نسخي يظهر ذلك بوضوح.
- الأسطر التي تبقى بخطها الأصلي تحتفظ بالحروف الفارسية التي في الملف في طبقة النص، كما ذكرنا.
- الأسطر المرسومة مرتين. بعض البرامج تحاكي الخط العريض أو الظل برسم كل glyph مرتين. ولا نستطيع أن نعرف أيّ النسختين هي النص، لذلك تبدأ خانة التعديل فارغة، وتكتب السطر بنفسك.
جرّبه، أو اقرأ الشيفرة
المحرر في صفحة تعديل PDF. اختر تعديل النص الموجود (ما زالت ميزة تجريبية)، ثم اضغط على سطر واكتب. وإن أردت ملفًا تجرّب عليه، فهذه صفحة الاختبار العربية التي نستعملها في المقارنات.
والشيفرة على GitHub في ogcalyps/blendpdf: كتابة النص الجديد في lib/pdf-text/، والإبقاء على خط الملف في lib/edit-pdf/keep-font/، وردّ الحروف الفارسية إلى العربية في lib/edit-pdf/prefill.ts. وإن كان لديك ملف PDF يخطئ فيه المحرر، فأنفع ما يمكنك فعله أن تفتح issue وترفق بها الملف.